OpenMP 数据并行
TIFF 按 z-slice 或 strip 分批;Zarr 按 chunk 分批。每个线程拿到互不重叠的数据区域,并行读取与解压。
本文重点分析 PetaKit5D 中的多层级并行处理,以及 OTF masked Wiener(OMW)反向投影器。内容同时参考论文的算法描述和仓库中的具体实现。
PetaKit5D 主要解决两个效率问题:一是超大图像的读取、写入和任务执行难以扩展;二是传统 Richardson-Lucy 反卷积需要较多迭代,计算量过大。
要实现在线处理,端到端处理速度至少应接近数据采集速度。如果前者较低,未处理数据会持续积压,也无法在实验过程中及时发现对焦、视野或采集参数错误。
PetaKit5D 的并行方案包含三个层级:文件内部的多线程读写、超大体数据的分块处理,以及集群层面的任务编排。这三个层级分别处理 I/O、内存容量和任务可靠性问题。
TIFF 按 z-slice 或 strip 分批;Zarr 按 chunk 分批。每个线程拿到互不重叠的数据区域,并行读取与解压。
单文件超出内存时,按空间子体积分割。卷积类操作增加 overlap/buffer,计算后只保留核心区再合并。
将函数、输入、输出和资源需求变成任务;持续监控 Slurm worker,跳过已有结果,失败后自动重交。
对单个处理批次而言,端到端延迟可以近似分解为读取、计算、写入和调度四部分。因此,只提高 GPU 计算速度并不能消除 I/O 瓶颈。
代码先读取 OpenMP 最大线程数,再计算 batchSize;每个 worker 独立打开 TIFF handle,读取自己的 directory 与 encoded strip。大二维图则进一步按 strip 并行。
TIFF 是单容器,多个线程同时改目录和 byte offset 会冲突。因此实现让 OpenMP 线程并行压缩 strips,同时由一个异步 writer 按顺序写入。它承认格式约束,并把最重的压缩部分并行化。
擅长兼容传统显微镜数据,但并行写入受容器目录结构限制。局部访问也容易牵涉更多连续数据。
一个空间块就是一个独立文件/对象。不同任务能只读取感兴趣区域,并把不同结果块并行写回,天然对应 split–process–merge。
| 问题 | 大 chunk | 小 chunk | 设计结论 |
|---|---|---|---|
| 固定 I/O / metadata 开销 | 摊薄,顺序吞吐高 | 重复支付较多 | 不要无限切小 |
| 并行任务数 | 少,粗粒度 | 多,负载均衡好 | 需足够多的 chunk 喂满 worker |
| 局部区域访问 | 可能读入无用数据 | 只读邻近块 | 根据算法访问模式 rechunk |
| 边界正确性 | 卷积/反卷积不能硬切:每个子体积需带 overlap | decon buffer ≥ PSF 半尺寸 + 额外余量(默认 10) | |
此时计算端仍是瓶颈;增加 worker 能提升总吞吐。
int32_t numWorkers = omp_get_max_threads();
int32_t batchSize = (z - 1) / numWorkers + 1;
#pragma omp parallel for
for (w = 0; w < numWorkers; w++) {
    // 每个线程只读取自己的 z-slice 批次
    TIFFReadEncodedStrip(tif, strip, destination, bytes);
}
显微镜成像可以表示为下式,其中 \(x\) 为真实样本,\(f\) 为点扩散函数(PSF),\(g\) 为观测图像,\(n\) 为噪声。RL 方法通过正向成像、误差计算和反向投影逐步估计 \(x\)。
观测与预测一致,该位置的校正因子接近 1,当前估计基本不变。
观测包含更多信号,误差反投影后会增加可能贡献到这里的样本位置。
当前估计贡献过强,反投影后的乘法修正会抑制对应位置。
它不是直接使用 1/H。因为当某个频率的 OTF 幅值 |H| 很小时,噪声会被无限放大。OMW 用 Wiener 项限制放大,用符合真实 OTF 形状的窗函数 W 决定哪些频率值得相信。
计算 \(H=\mathcal F\{f\}\),用 \(|H|\) 描述显微镜对各空间频率的传递能力。
将 \(|H|\) 从大到小排序,默认取累计和达到 90% 的位置作为阈值;代码另设 \(10^{-3}\) 的最低阈值以应对噪声。
形态学开闭运算去噪;常规空间保留中央主对象,skewed space 则处理三个主要分量。
逐切面做凸包填充,避免噪声孔洞和凹缺让高频信息被不规则切断。
从频谱中心沿射线归一化:中心为 0,真实支持域边界为 1,不再假设所有 PSF 都是椭球。
默认 \(D<0.8\) 全通过,\(0.8\leq D<1\) 平滑衰减,\(D\geq1\) 为零,以减少硬截断引起的振铃。
计算 \(B=W\odot H^*/(|H|^2+\alpha)\),再经逆 Fourier 变换得到迭代使用的 \(b\)。
OTF_bp_w = conj(OTF) ./
           (abs_OTF.^2 + alpha);
OTF_bp_omw = OTF_bp_om .* OTF_bp_w;
b_omw = fftshift(real(ifftn(OTF_bp_omw)));
CX = real(ifftn(fftn(J) .* OTF_f));
CX = max(CX, eps);
J = real(ifftn(fftn(I ./ CX)
    .* OTF_b)) .* J;
J = max(J, 0);
| 方法 | 反向投影器 | 优点 | 主要问题 / 改进 |
|---|---|---|---|
| 传统 RL | matched projector | 准确、稳健、通用 | 通常要 10–100 次迭代,PB 数据计算代价高 |
| WB | Wiener–Butterworth | 少量迭代即可收敛 | 椭球支持域可能截断 lattice light-sheet 的近矩形高频区域 |
| OMW | OTF mask × Wiener | 1–2 次常可达到全分辨率;适配任意 PSF 支持域 | α 与迭代数仍需数据驱动选择;论文用 FSC 辅助确定 |
下面才进入我们的工作。顺序是:先识别 RL 的精确反向传播,再分析 OMW 改写 backward projector 的收益与代价;随后用 Newton/Fisher 看清病态曲率,最后构造保留 \(H^{\mathsf T}\) 的频谱预条件与正则化更新。
输出层的 Poisson error signal 与传回图像域的梯度为:
归一化 PSF 下,RL 可写成 \(x_{k+1}=x_k-\operatorname{Diag}(x_k)g_k\)。因此它是全批量 scaled gradient,而不是随机采样意义上的 SGD。
OMW 保持 forward 为 \(H\),但用 inverse-like 的 \(B^{\mathsf T}\) 代替链式法则决定的 \(H^{\mathsf T}\):
弱传递频率得到更强校正,因此前几轮很快;代价是 \(B^{\mathsf T}\delta\) 一般不再等于原 Poisson 目标的梯度,继续迭代也更容易放大噪声。
完整 Newton 要反复求解空间变权的病态线性系统;更重要的是,小 Fisher 特征值正对应弱 OTF 与噪声主导方向,直接求逆会给予这些方向最大增益。
不替换 \(H^{\mathsf T}\)。在正值 log-intensity 层继续反传,并在 OTF 支持域中做分数 Fisher 白化:
\(\beta=0,\tfrac14,\tfrac12,1\) 分别连接 log-SGD、半白化、全白化和近似逆 Fisher;这使候选方法来自一条可解释的连续谱,而不是任意替换反向算子。
SCR-RL 在早期使用较强的 OTF 对角逆曲率,随后几何退火回 RL 尺度;每轮再施加二阶 Sobolev 近端滤波,抑制不可辨识高频的 Poisson 噪声。
验证采用 12 个独立 Poisson seeds。所有方法在每个 seed 内使用相同观测、相同初始化并统一比较第 4 轮;数值与置信区间由全部 seeds 计算,恢复图展示多种子结果中具有代表性的 seed 31,并对所有方法使用相同显示范围。
k = 4 for every method · n = 12 held-out seeds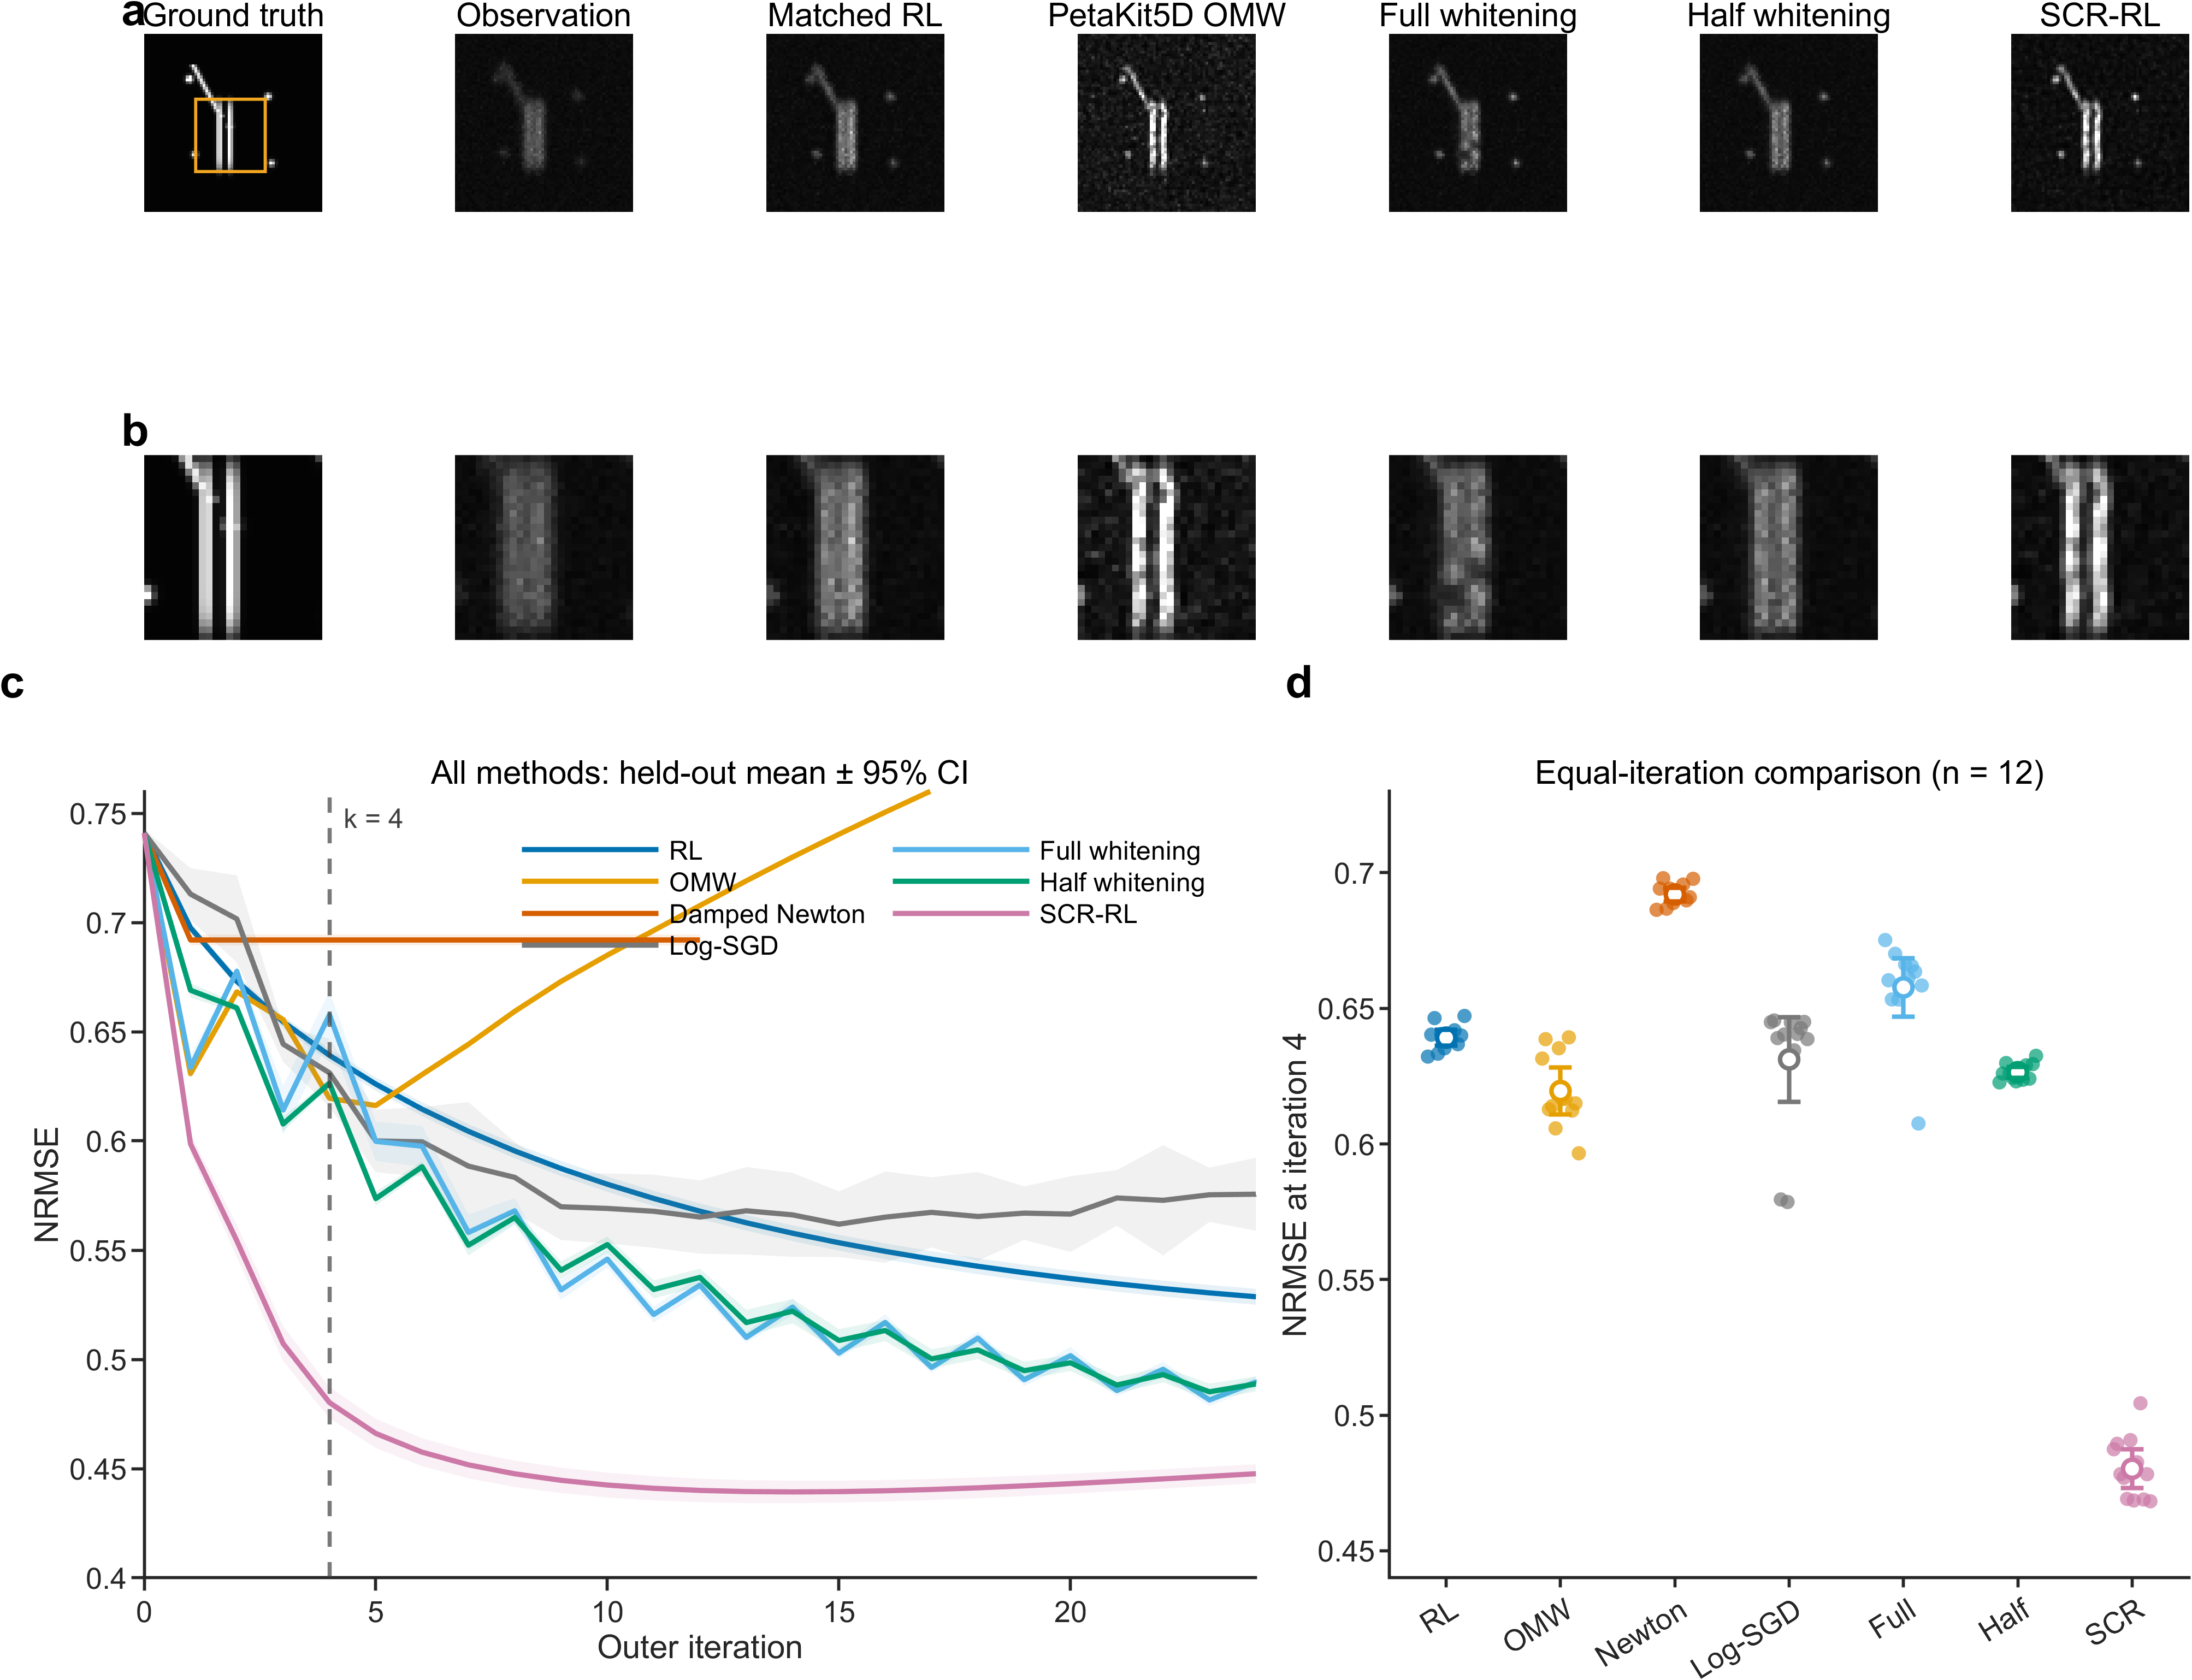
| 方法 | 统一轮次 | Held-out NRMSE ↓ | PSNR ↑ | 第 4 轮观察 |
|---|---|---|---|---|
| Matched RL | 4 | 0.6392 ± 0.0029 | 33.345 dB | 稳定,但细丝仍明显模糊 |
| PetaKit5D OMW | 4 | 0.6195 ± 0.0086 | 33.618 dB | 细丝分离更快,同时出现颗粒噪声 |
| Damped Newton | 4 | 0.6920 ± 0.0025 | 32.655 dB | NLL 下降未转化为恢复误差改善 |
| Log-SGD | 4 | 0.6312 ± 0.0156 | 33.460 dB | 正值参数化本身不足以解决病态频率 |
| Full Fisher whitening | 4 | 0.6577 ± 0.0108 | 33.099 dB | 保守线搜索使早期校正仍慢 |
| Geometric half whitening | 4 | 0.6264 ± 0.0020 | 33.519 dB | 早期优于 RL,但未超过 OMW |
| SCR-RL | 4 | 0.4802 ± 0.0071 | 35.830 dB | 逆曲率负责快速分离,先验抑制颗粒噪声 |
这张图回答的是“相同外层迭代预算下谁恢复得更好”。第 4 轮时,SCR-RL 相对 RL 和 OMW 的配对 NRMSE 分别改善 24.86% 与 22.48%,两项 Holm-adjusted \(p=0.00293\)。方法各自最佳轮次的冻结终点属于另一个问题,不再用于恢复图的横向视觉比较。