研究成果
论文成果
研究涵盖类脑学习、大语言模型、多模态学习与智能决策。
 ICML 2026
第一作者 | 北京大学
ICML 2026 | 已录用
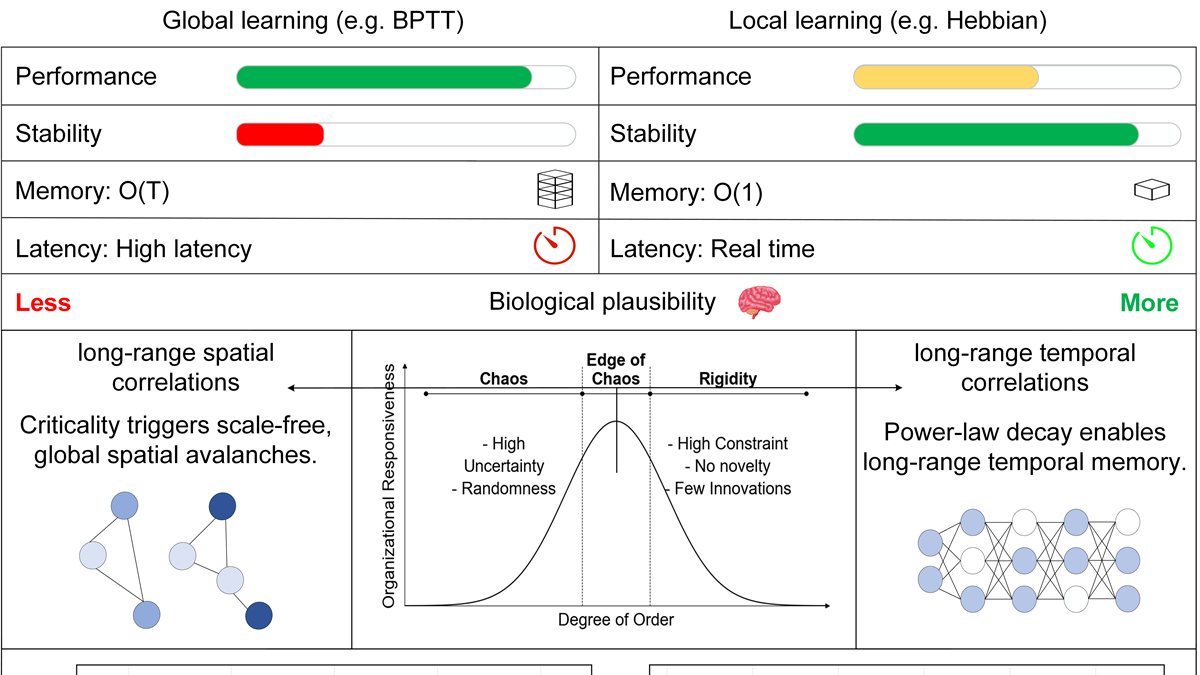
该 ICML 2026 论文聚焦循环、卷积循环与脉冲系统中的时序信用分配问题,提出基于临界动力学、具有常数激活内存开销的在线局部学习规则。
研究内容与个人贡献
- 围绕 BPTT 之外的时序信用分配问题,提出基于临界动力学的局部学习规则。
- 利用空间长程惯量和时间长程关联,将全局信用传播近似为局部可计算教学信号。
- 推导仅需常数级激活内存与 O(H) 辅助状态的闭式更新,并在 RNN、ConvRNN 和 SNN 上验证精度、稳定性与可扩展性。
 IEEE COMST 2025
Ning Yang, Mingrui Fan, Wentao Wang, Haijun Zhang
第三作者(导师一作) | 中国科学院自动化研究所
IEEE COMST | 已发表
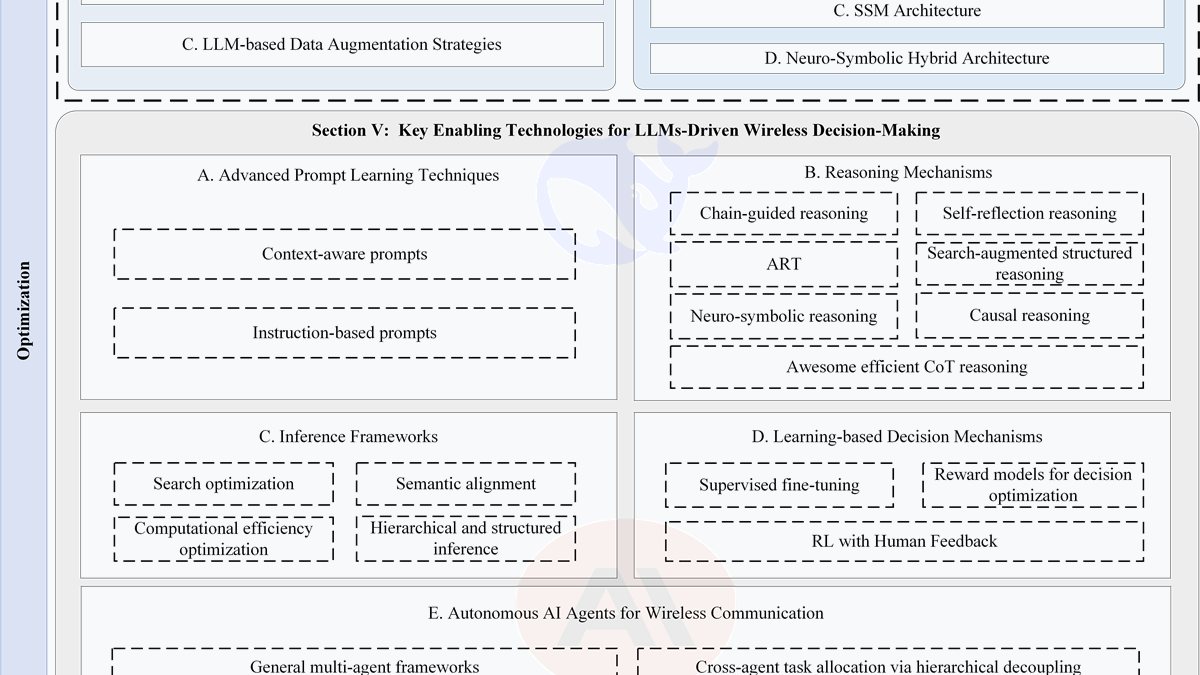
该综述系统总结无线通信中决策型大语言模型的数据构建、架构适配、推理控制、多智能体协同与开放问题。
研究内容与个人贡献
- 系统梳理无线通信场景下 LLM 决策研究,覆盖数据、模型、推理、控制与多智能体协同等关键维度。
- 我主要负责数据生成与增强、架构适配以及开放问题等部分的撰写。
- 论文已发表于 IEEE Communications Surveys & Tutorials。
 IEEE TMC
Ning Yang, Wentao Wang, Lingtao Ouyang, Haijun Zhang
第二作者(学生一作,导师一作) | 中国科学院自动化研究所
IEEE TMC | 已录用
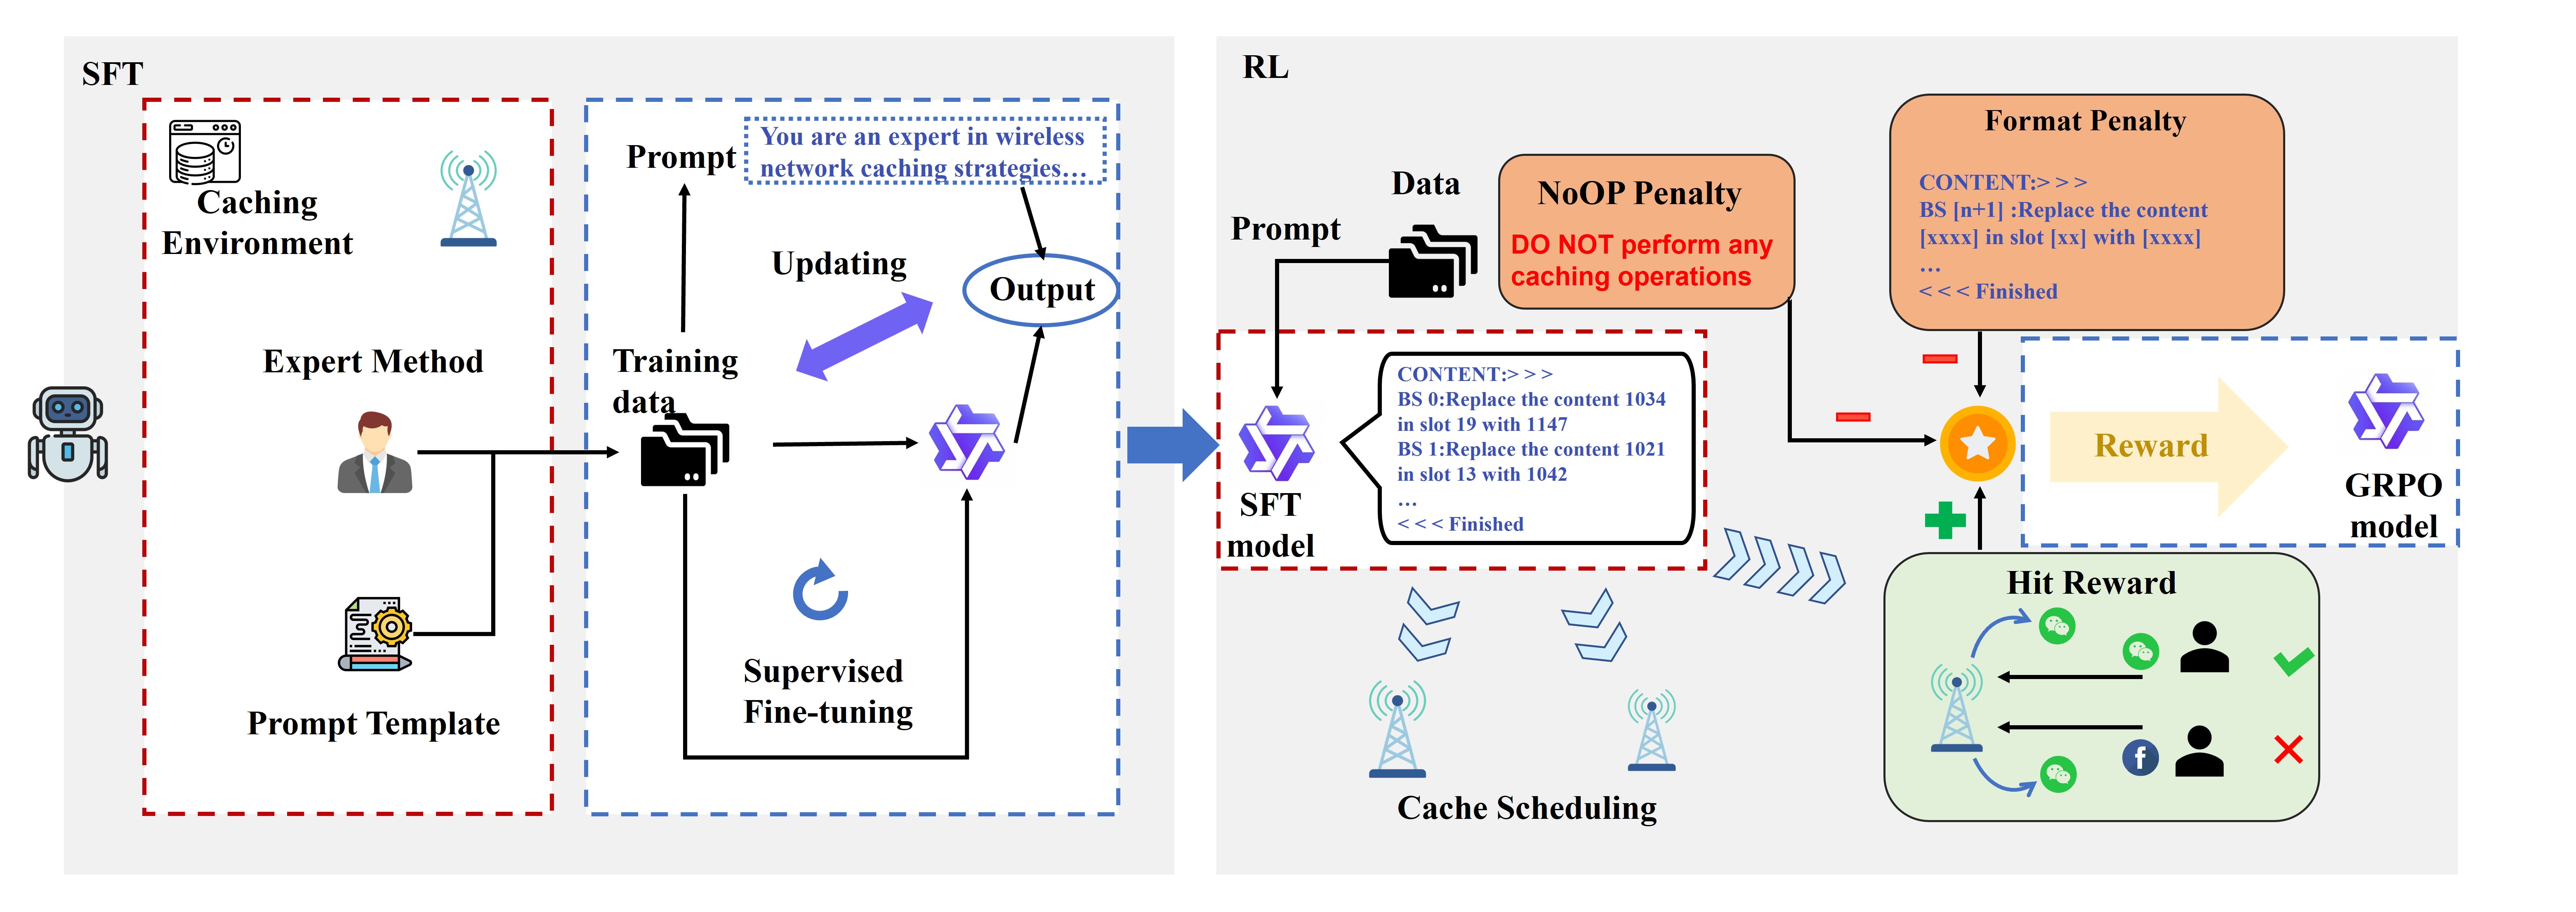
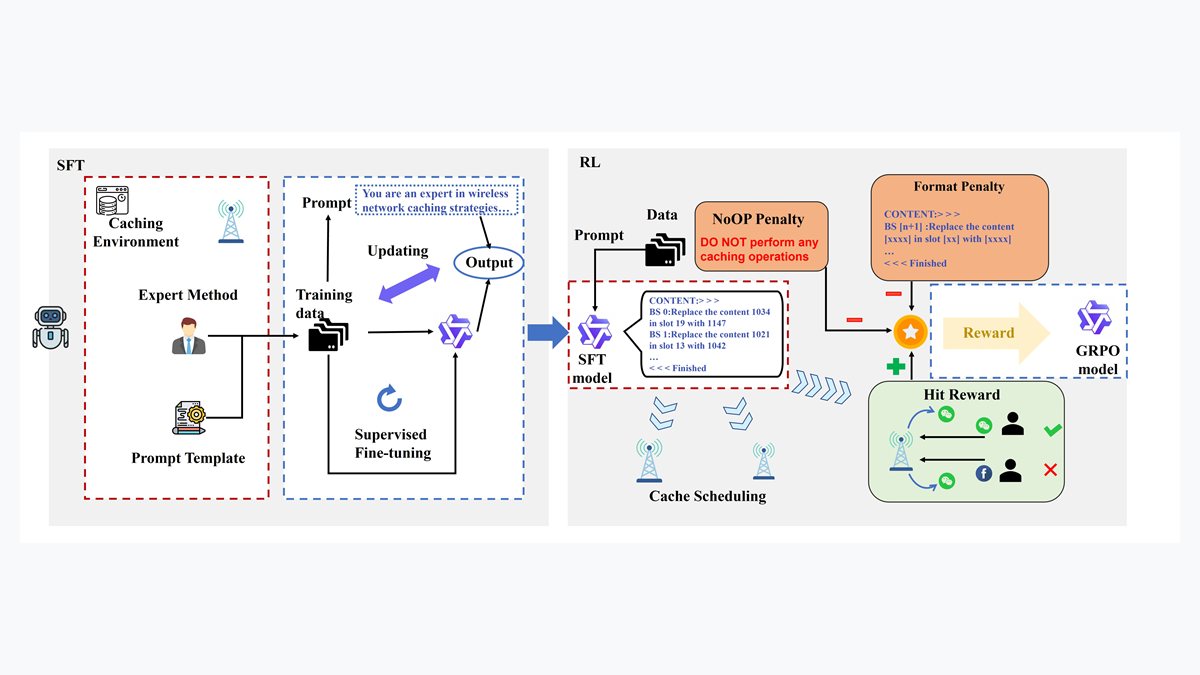
将多基站协同边缘缓存问题建模为 LLM 原生的序列决策任务,构建 SFT+GRPO 训练流程,并设计机会感知奖励函数。
研究内容与个人贡献
- 构建多基站、多用户协同边缘缓存环境,并将任务表述为 LLM 原生的序列决策问题。
- 基于严格约束的文本到动作接口,实现 SFT+GRPO 两阶段训练流程,并结合 TRL、Unsloth 与 QLoRA。
- 在用户规模、基站数量和请求分布变化下表现出良好泛化性。
 ICONIP 2026
第一作者 | 大连理工大学
ICONIP 2026 | 已录用
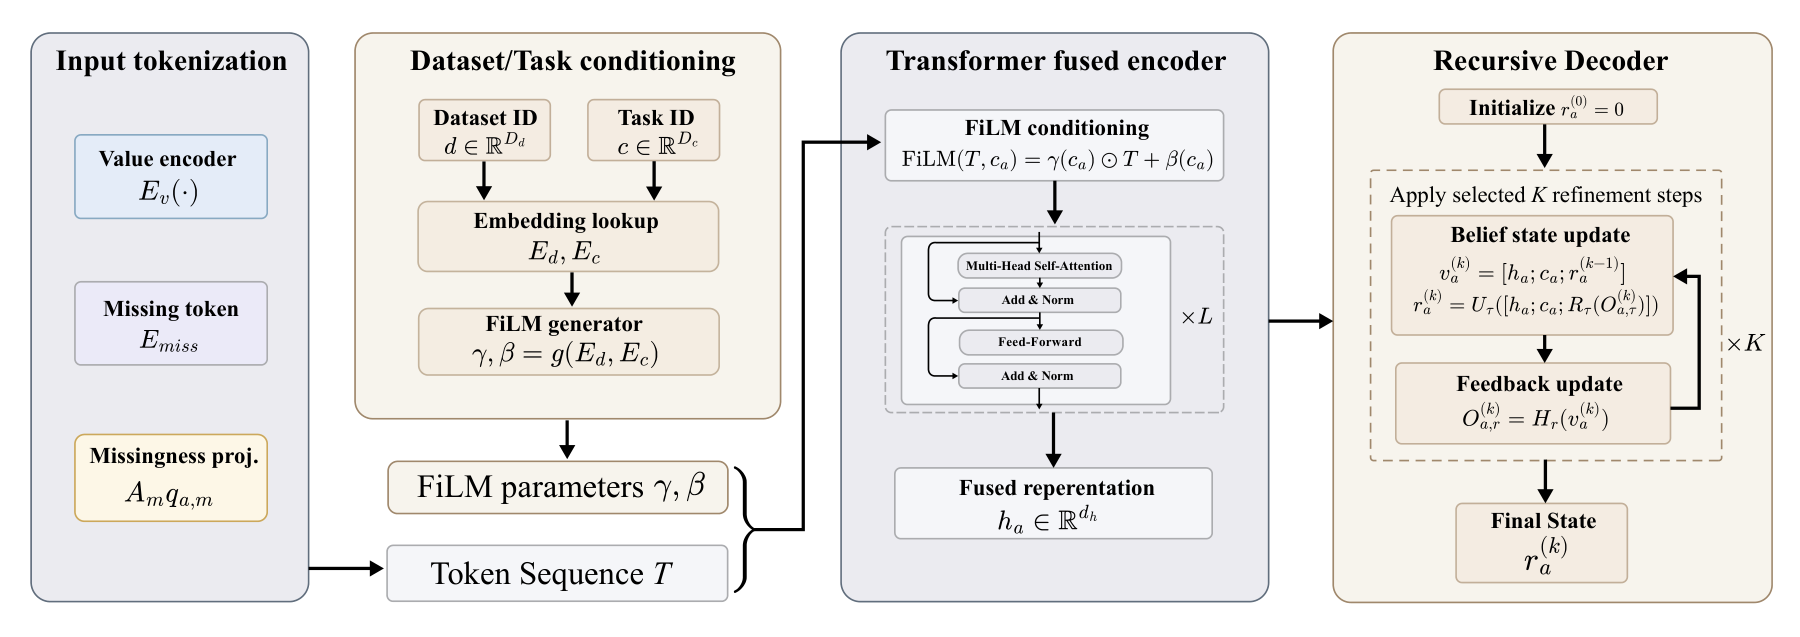
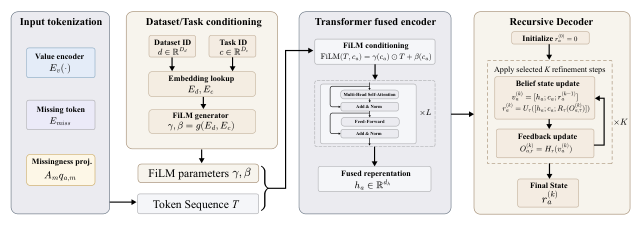
面向异步、缺失的移动与可穿戴心理健康特征视图,通过独立编码、缺失信息建模、共享–私有潜变量及任务条件递归融合,实现多任务预测。
研究内容与个人贡献
- 对各特征源独立编码,并显式融入缺失信息。
- 结合共享–私有潜变量、任务条件融合与递归预测,实现多任务建模。
- 在 DepreST-CAT 和 PSYCHE-D 的六项任务上取得领先或有竞争力的结果。
 NeurIPS 2026
共同一作(导师一作) | 中国科学院自动化研究所
NeurIPS 2026 | 已录用
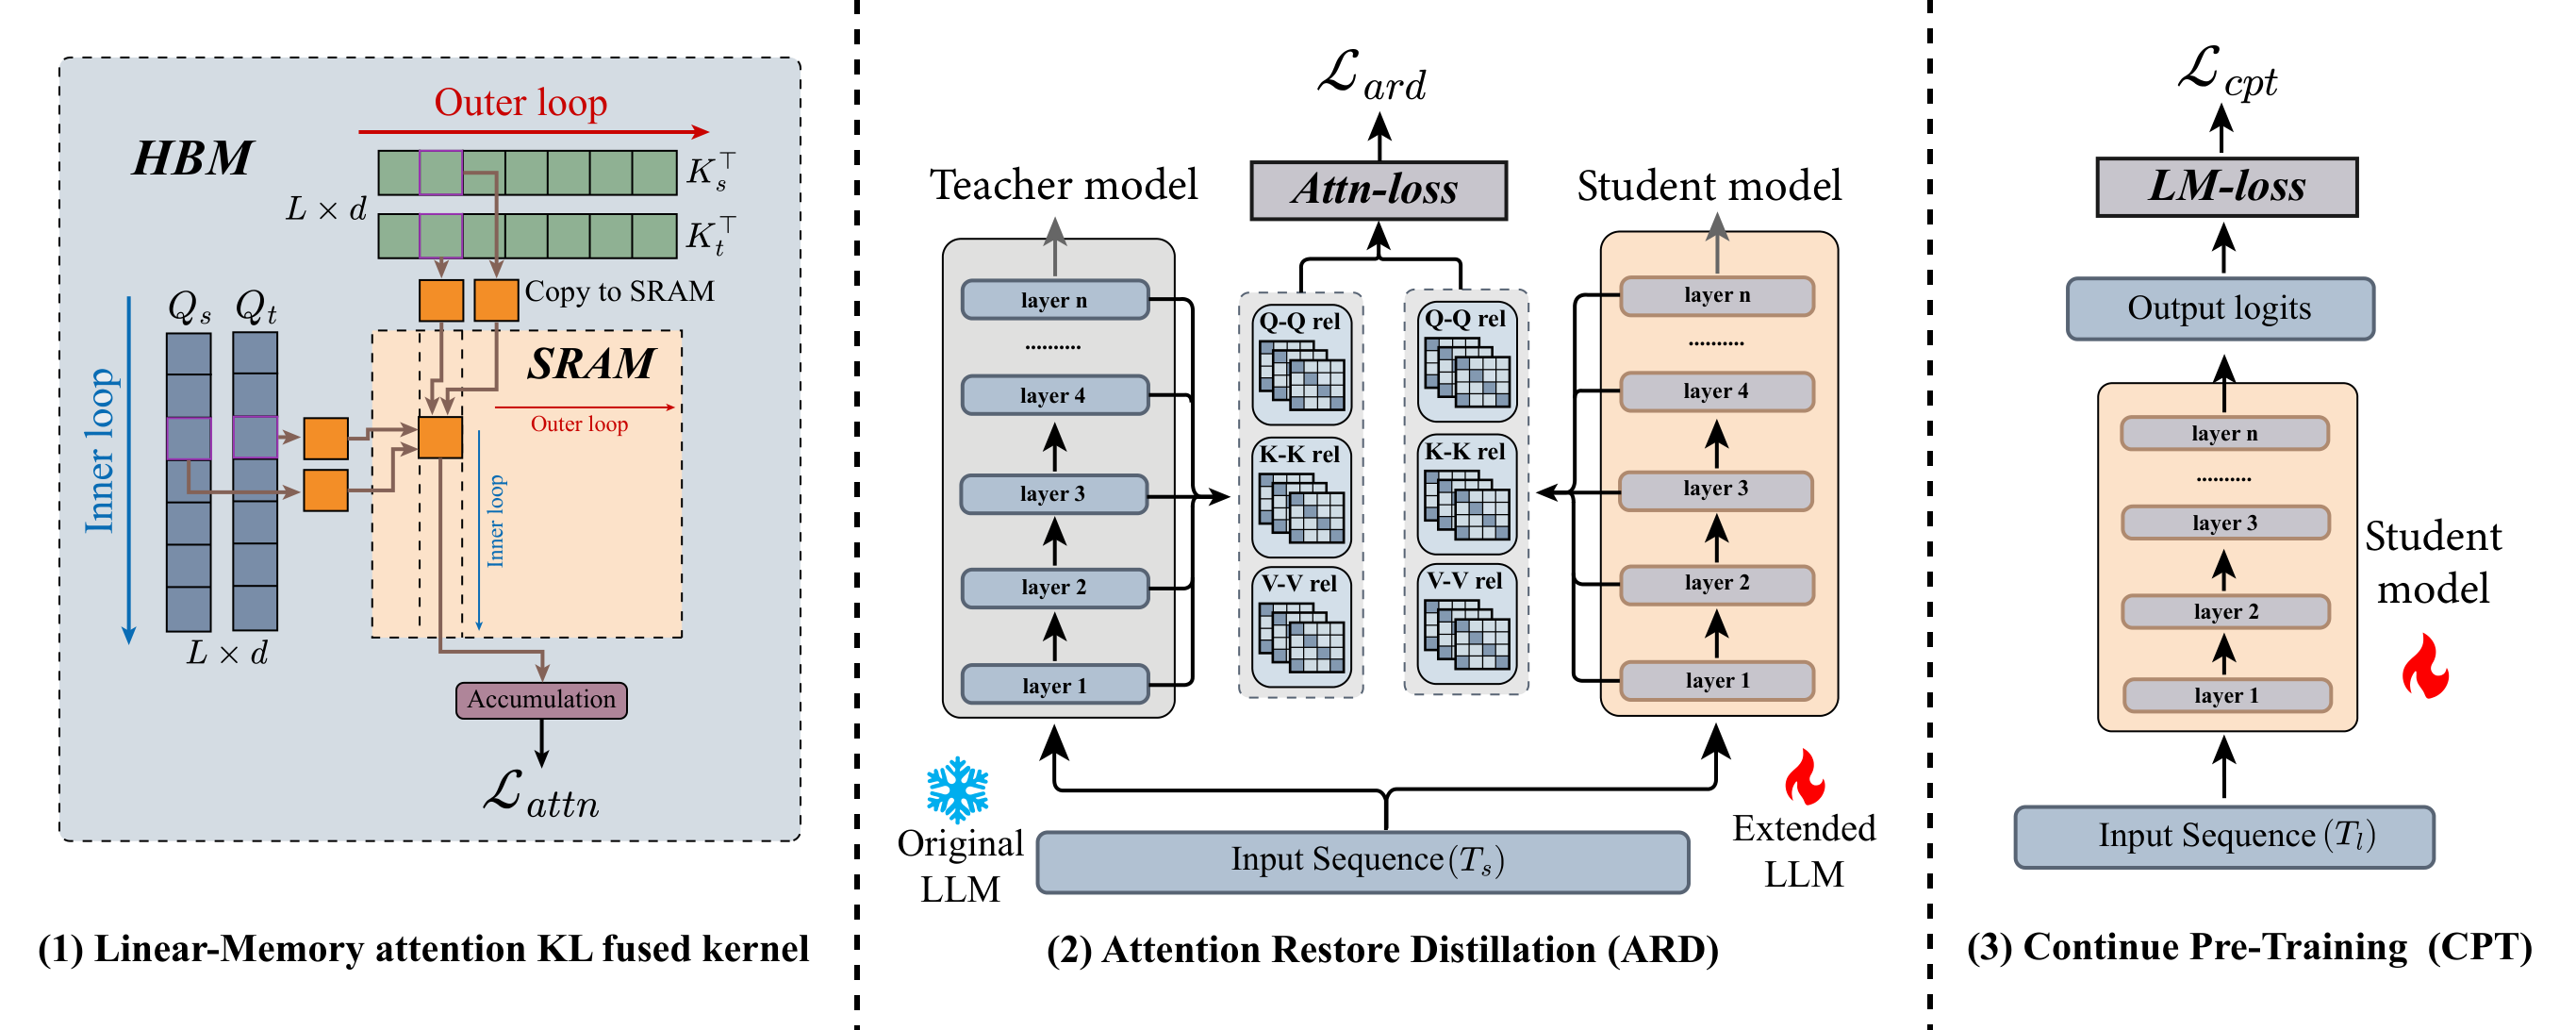
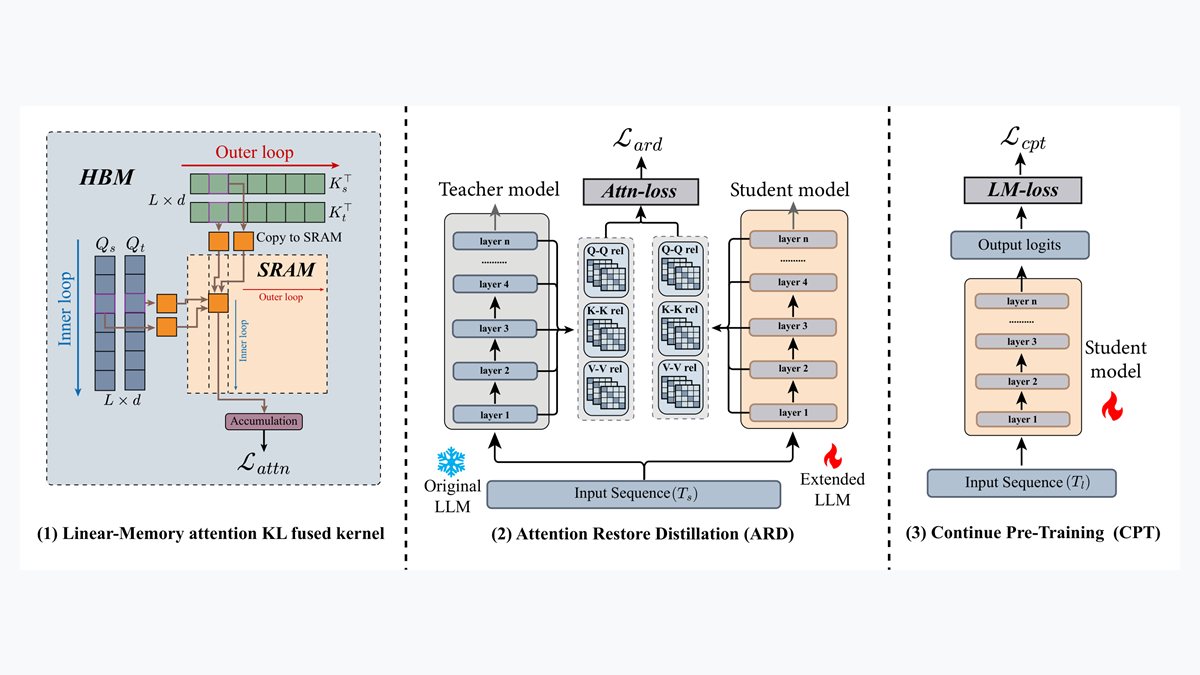
LinearARD 通过对齐原生 RoPE 教师与缩放 RoPE 学生的行级稠密自关系,实现长上下文恢复蒸馏,并推导精确的线性内存 KL 散度核。
研究内容与个人贡献
- 提出一种面向长上下文 LLM 的恢复蒸馏框架,对齐原生 RoPE 教师模型与缩放 RoPE 学生模型之间的行级自关系分布。
- 推导精确的线性内存 KL 核,避免显式构造完整关系矩阵。
- 在 LLaMA2-7B 从 4K 扩展到 32K 的设定下,仅用 4.25M 训练 token 即恢复 98.3% 的短上下文性能。
- 本人负责全文撰写。
 MAJOR REVISION
Wentao Wang, Lifeng Han, Guangyu Zou
第一作者 | 大连理工大学
Applied Intelligence | 大修
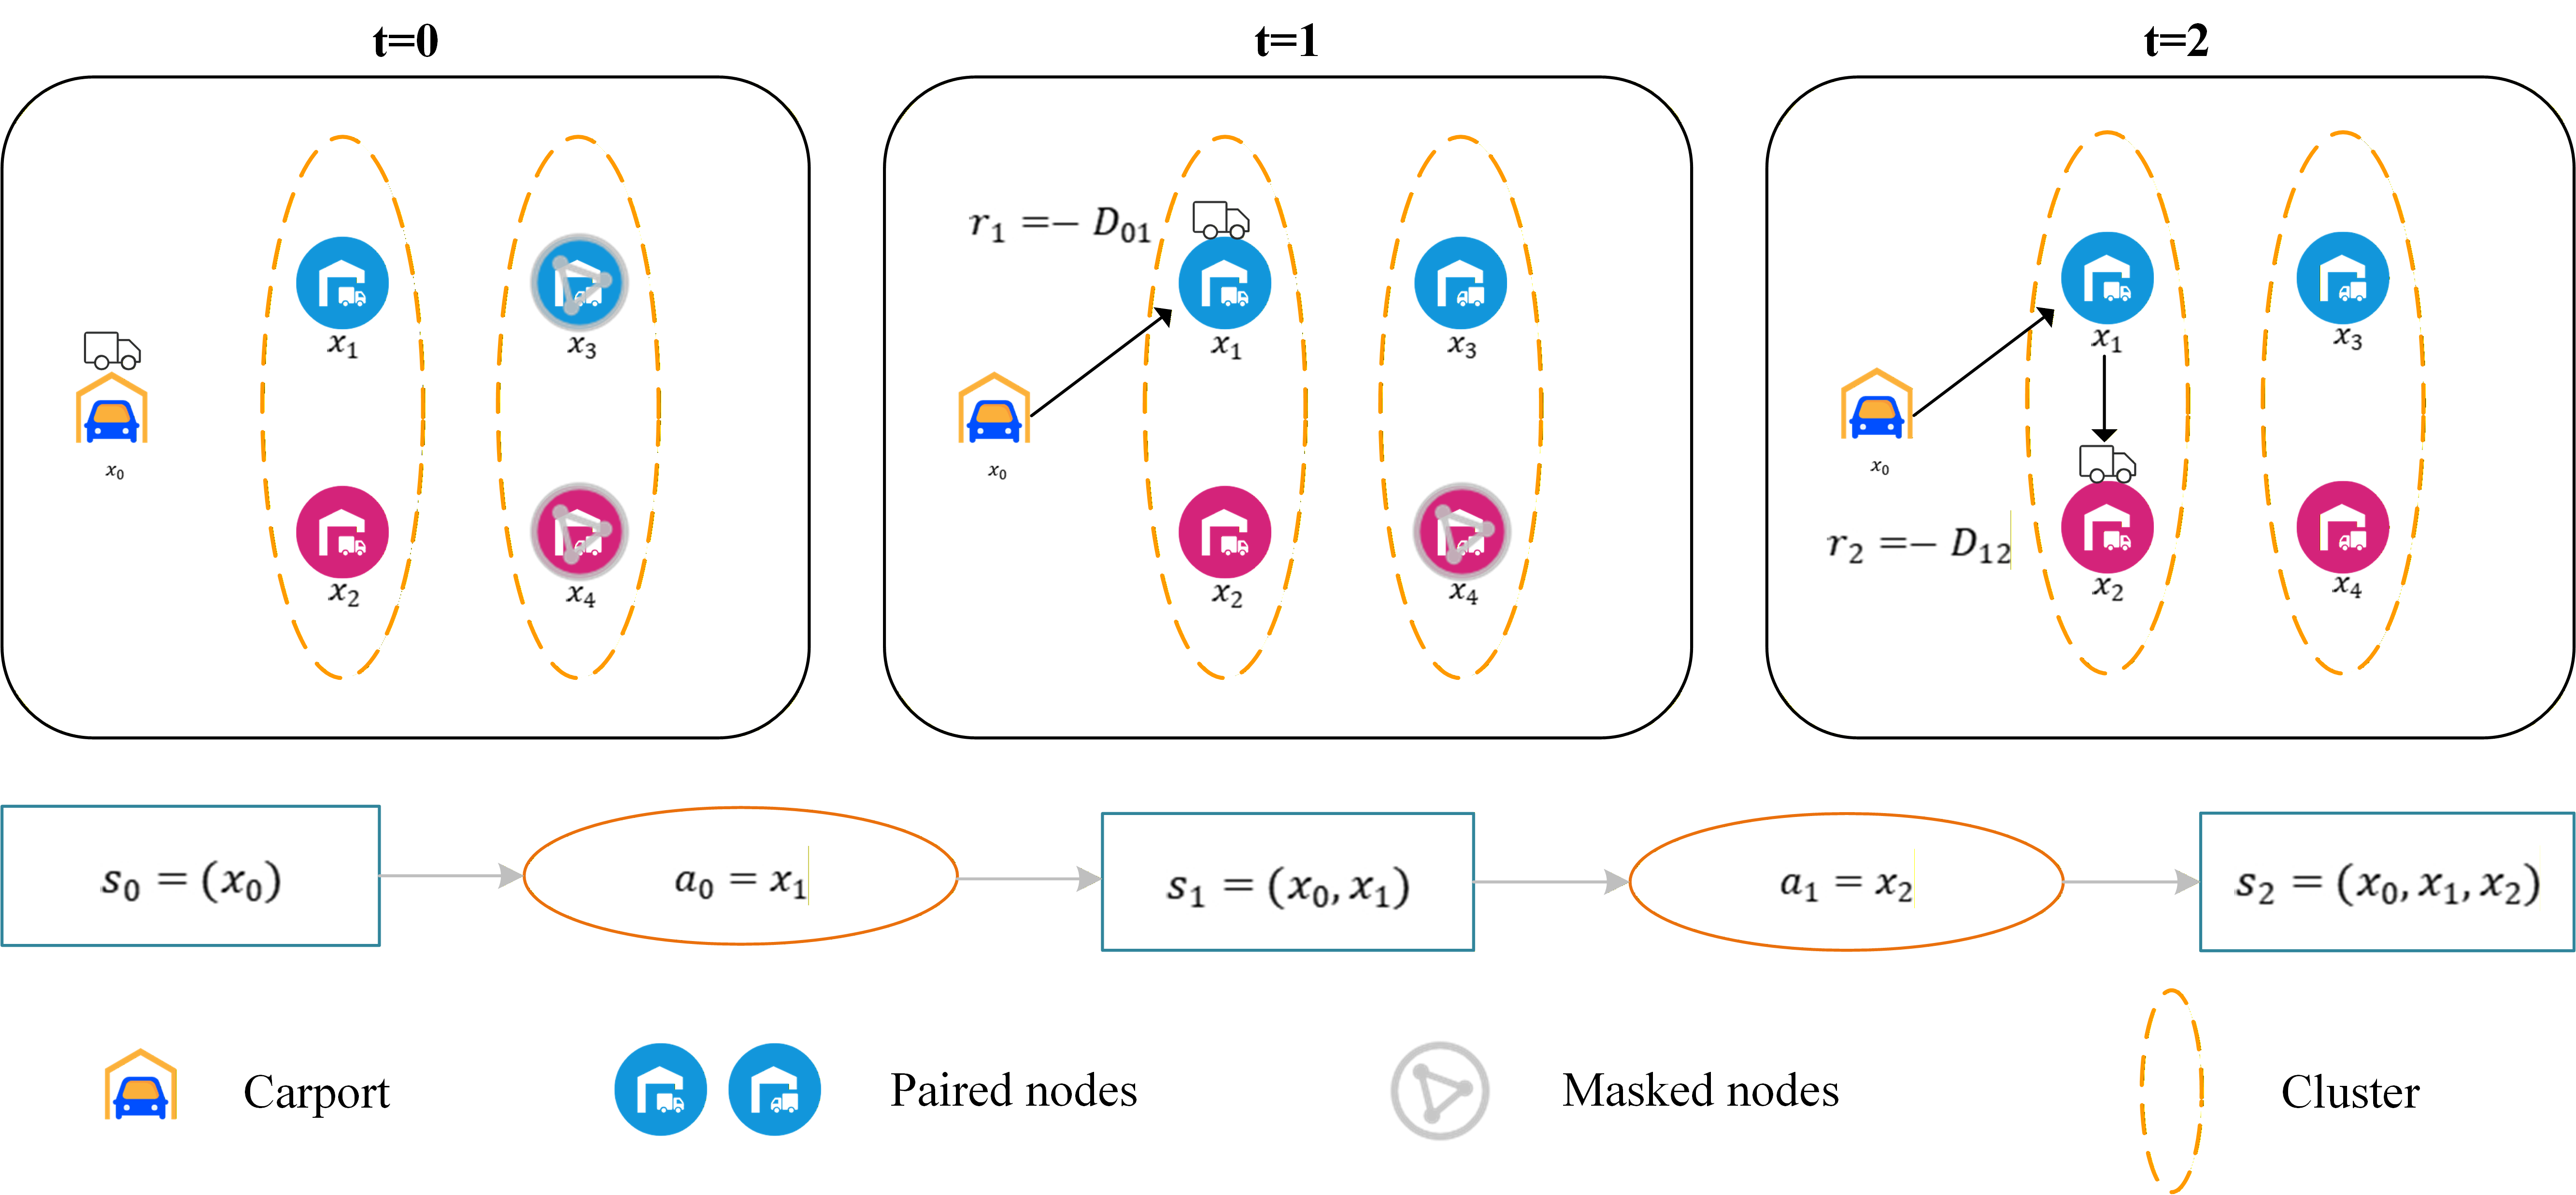
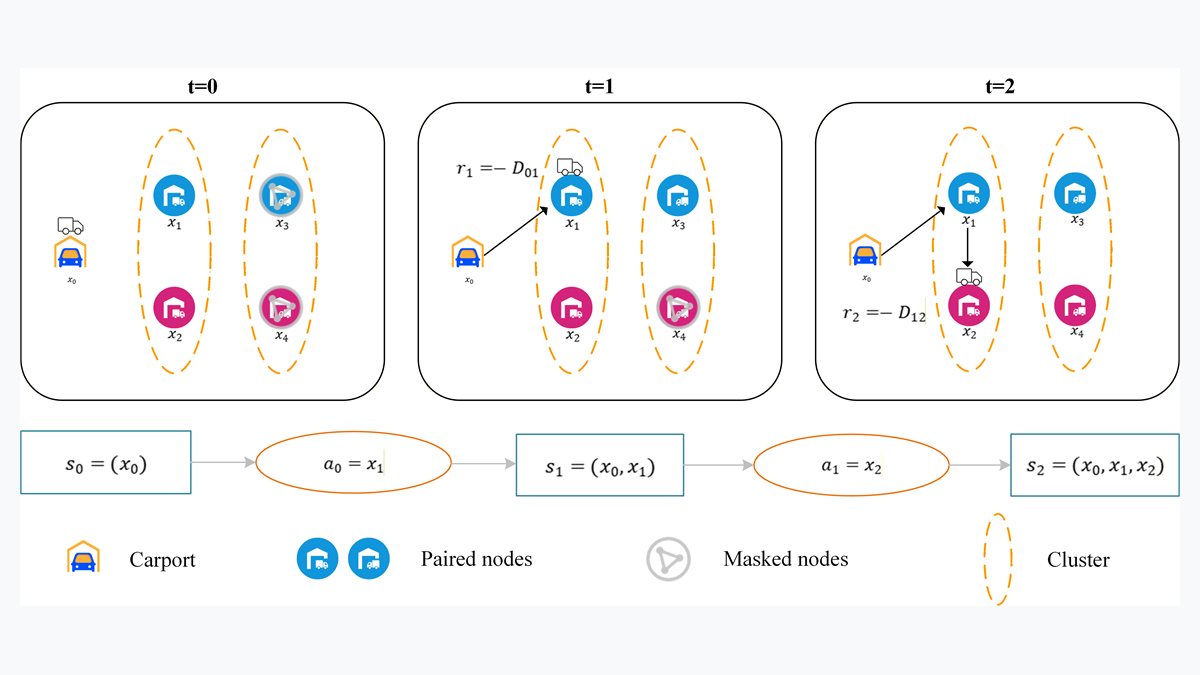
提出 CAADRL 框架,将全局自注意力、簇内注意力与动态双解码器结合,显式利用取送货问题中的聚类结构,并显著降低推理时延。
研究内容与个人贡献
- 提出 CAADRL 框架,用于建模带簇结构的取送货路径优化问题。
- 将全局自注意力、簇内注意力与带门控的动态双解码器结合,实现宏观簇间决策与微观簇内决策协同。
- 在簇状基准上取得领先结果,同时显著降低相对神经协同搜索方法的推理开销。
← 返回主页
 ICML 2026